AIの成績くらべ。各社のいちばん賢いAIを、3つの物差しで並べました
いま、いちばん賢いAIはどれなのか。
AIの会社の分け方を調べたついでに、各社のいちばん上のAIの成績も並べてみました。 AIの成績を測っている第三者のサイト3つから数字を集めて、グラフにしています。
結果から言うと、上位はアメリカの3社。 そのすぐ下に、中国の会社が並んでいます。
📏 3つの物差しで比べました
AIの「賢さ」は、ひとつの点数では決まりません。 なので、測り方の違う3つの物差しを使いました。
- ① 総合点:Artificial Analysis というサイトが、10種類のテスト(作業の代行・プログラミング・理系の推論など)をまとめた点数
- ② とても難しい試験:専門家が作った難問の試験「Humanity's Last Exam」の正答率。検索などの道具は使わずに解いたもの
- ③ 人の投票:LMArena というサイトで、同じ質問への2つの答えを人が見比べて、良いほうに投票した結果の点数
各社1本ずつ、いちばん成績のよいモデルを選んでいます。 グラフの色は国で、青はアメリカ、オレンジは中国、緑はヨーロッパの会社です。
📊 ① 総合点
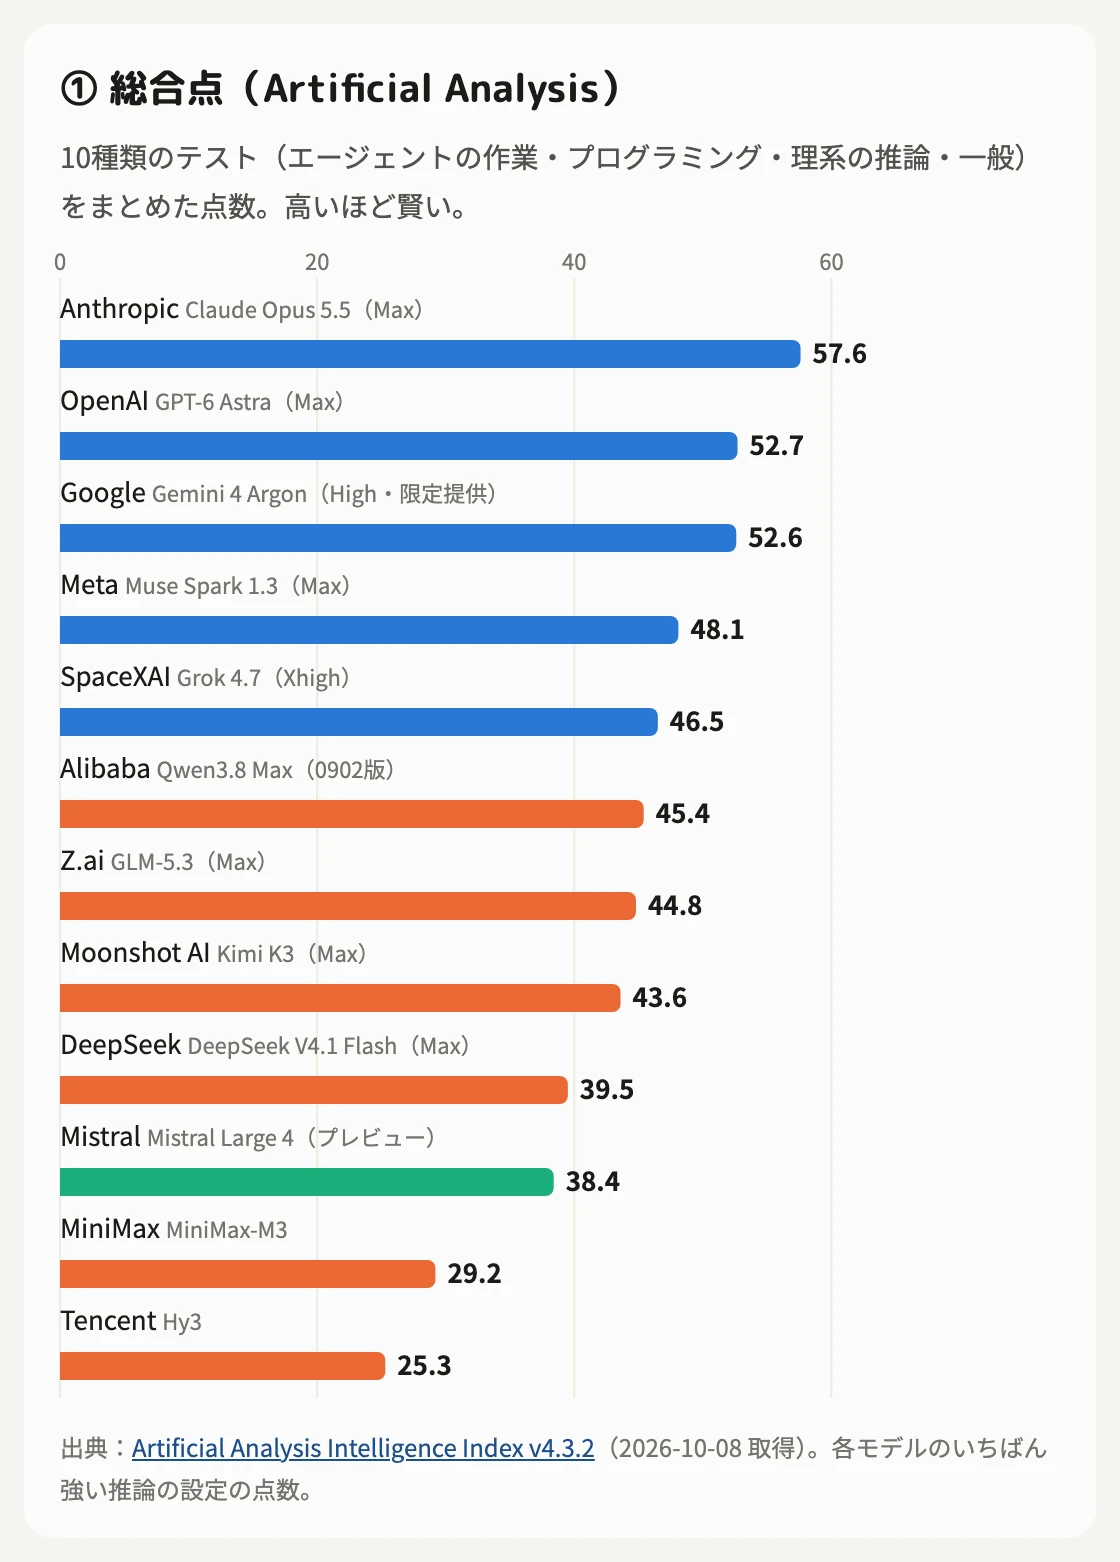
1位は Anthropic の Claude Opus 5.5。 2位以下の OpenAI と Google はほぼ同点で、そのあとに Meta、Grok と続きます。
中国の会社では、Qwen(Alibaba)、GLM(Z.ai)、Kimi(Moonshot AI)が上位です。 トップとの差は、12〜14点ほどです。
出典:Artificial Analysis Intelligence Index v4.3.2(英語)(2026年10月8日に取得)
🧠 ② とても難しい試験
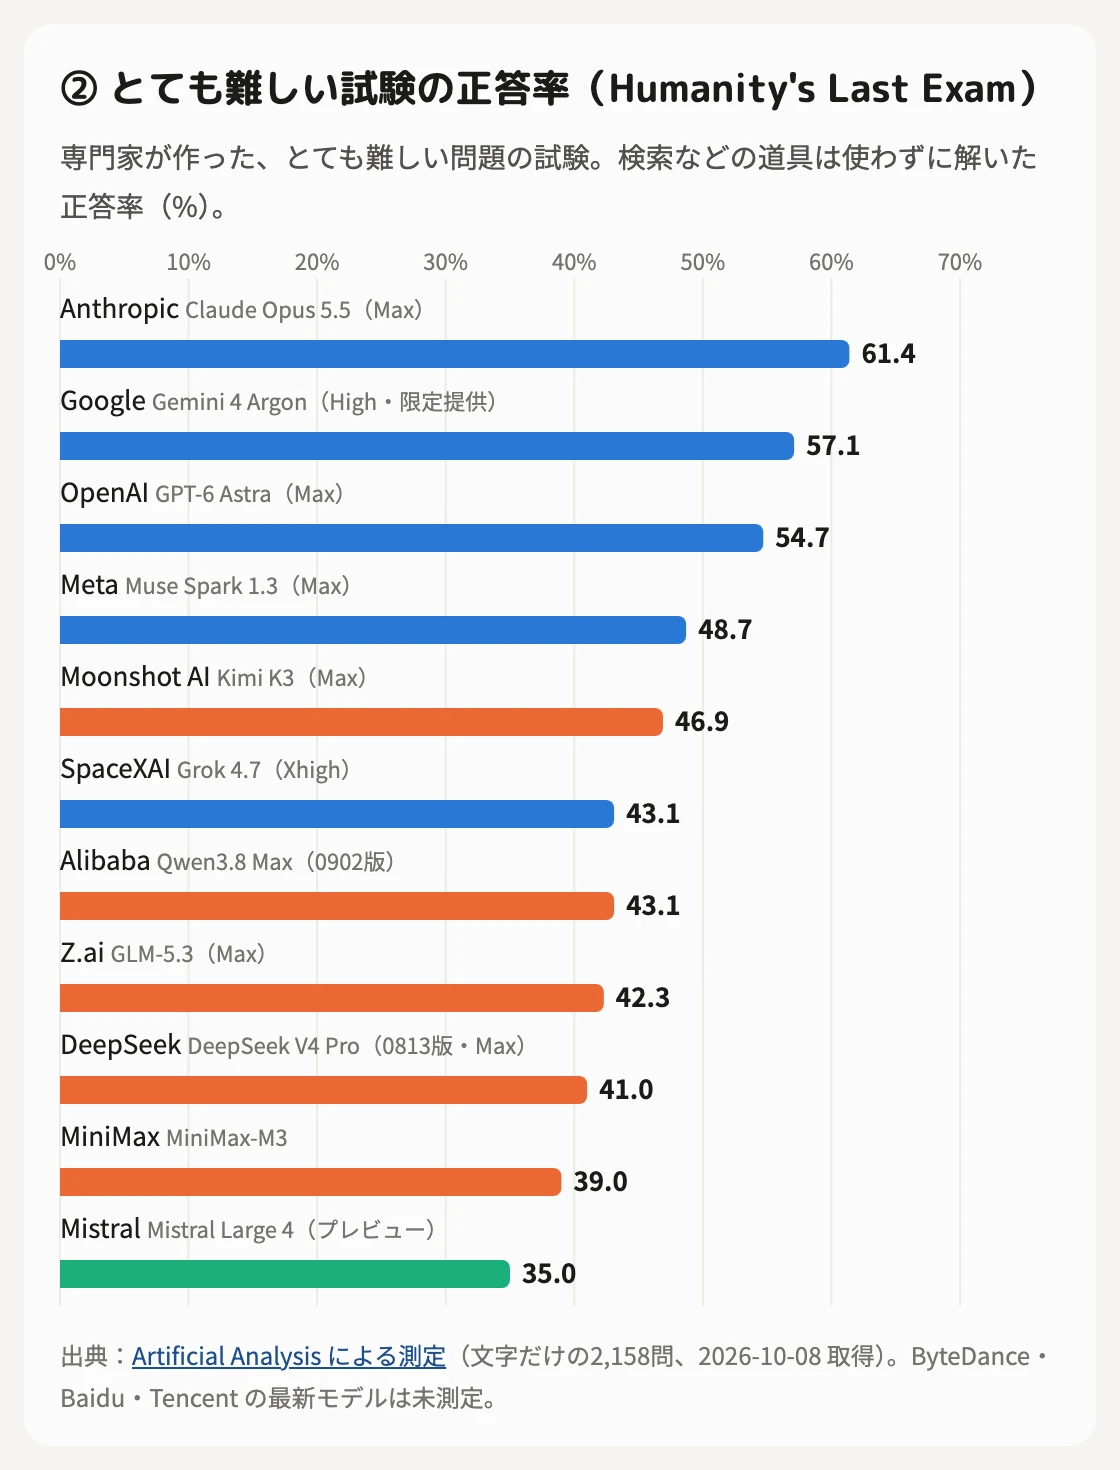
人間の専門家でも難しい問題です。 いちばん上でも正答率は6割ほど。まだ全部は解けないんですね。
順位は総合点とほぼ同じですが、中国の Kimi K3 が少し上がって5位に入っています。
出典:Artificial Analysis による測定(英語)(文字だけの2,158問、2026年10月8日に取得)
🗳️ ③ 人の投票
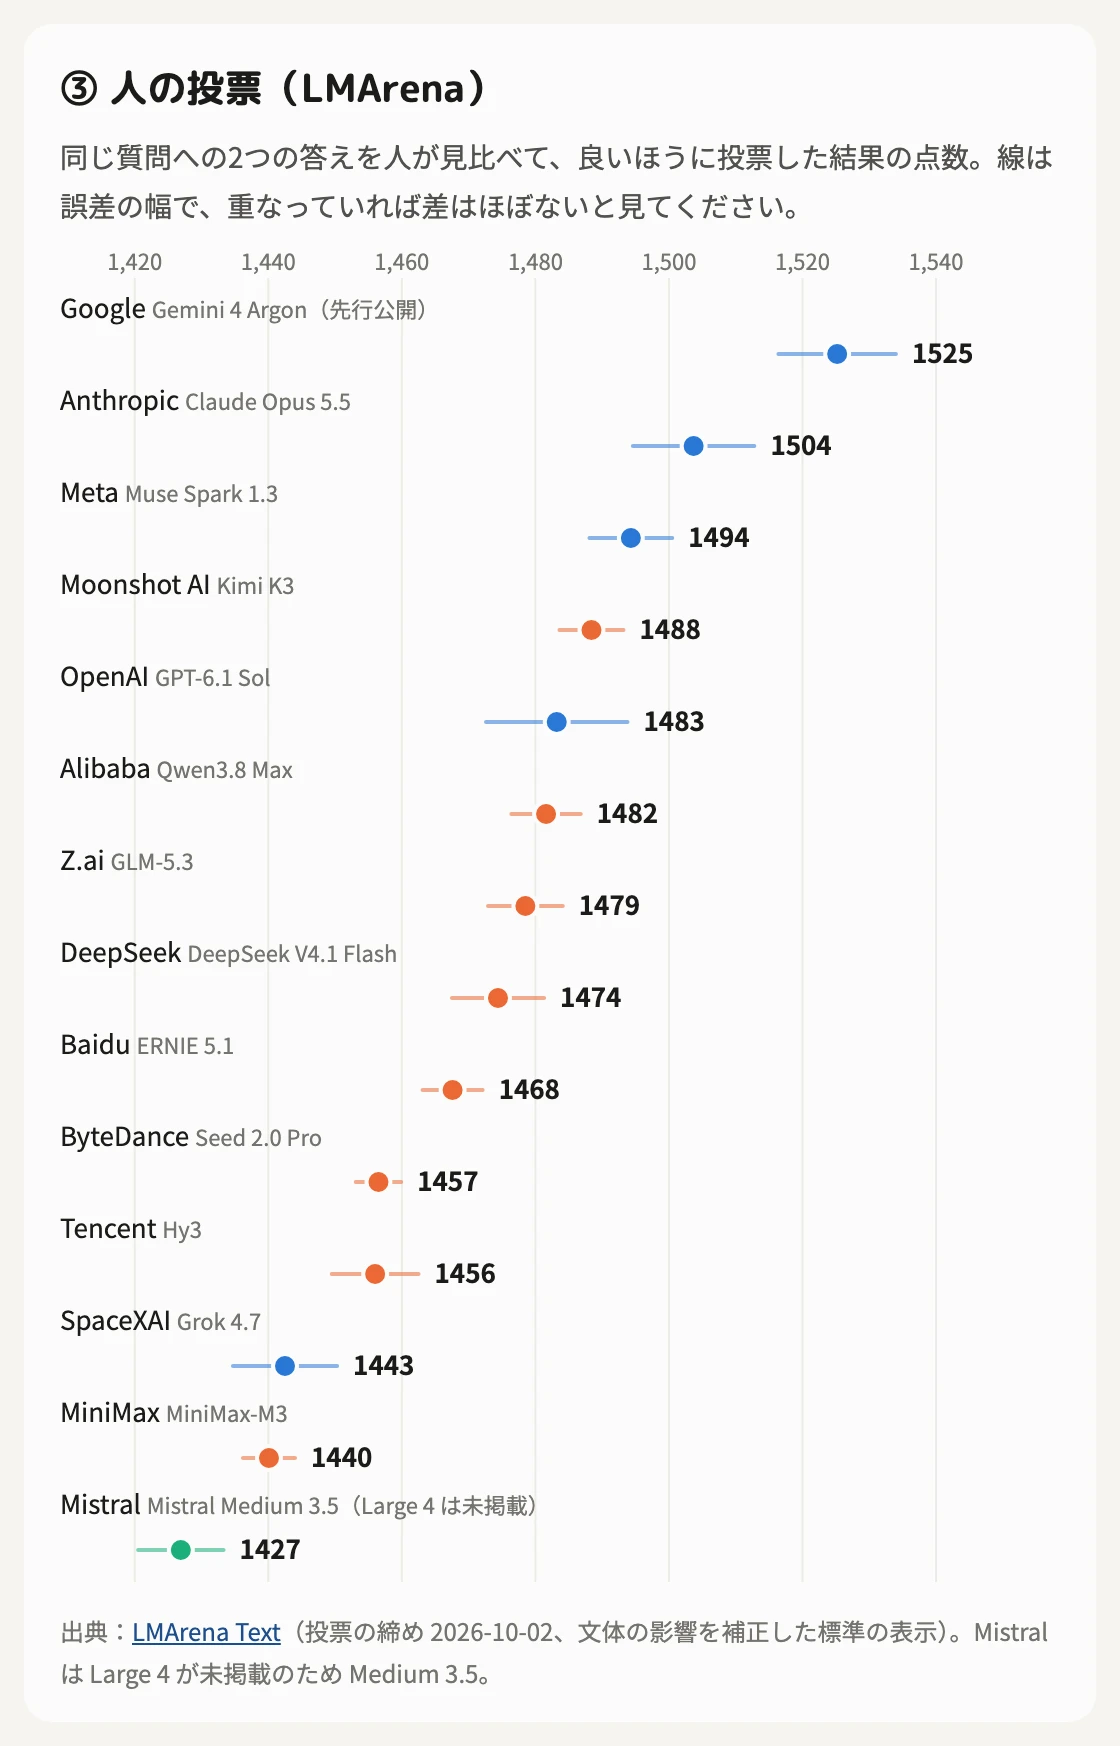
これは「人がどっちの答えを好んだか」の点数です。 点数の差が小さいので、棒ではなく点で表しています。 横の線は誤差の幅で、線が重なっていれば、ほぼ同じくらいと見てください。
ここでは、中国の Kimi K3 が OpenAI より上に来ています。 一方で Grok は、総合点に比べて順位が下がっています。 試験の点数と、人が使って「いいな」と思うかは、少し別なんですね。
出典:LMArena Text(英語)(投票の締め 2026年10月2日、文体の影響を補正した標準の表示)
📋 表で見る
| 順位 | 会社(モデル) | 国 | 総合点 | 難問の試験 | 人の投票 |
|---|---|---|---|---|---|
| 1 | Anthropic Claude Opus 5.5 | 米国 | 57.6 | 61.4% | 1504 |
| 2 | OpenAI GPT-6 Astra | 米国 | 52.7 | 54.7% | 1483 GPT-6.1 Sol |
| 3 | Google Gemini 4 Argon | 米国 | 52.6 | 57.1% | 1525 |
| 4 | Meta Muse Spark 1.3 | 米国 | 48.1 | 48.7% | 1494 |
| 5 | SpaceXAI Grok 4.7 | 米国 | 46.5 | 43.1% | 1443 |
| 6 | Alibaba Qwen3.8 Max | 中国 | 45.4 | 43.1% | 1482 |
| 7 | Z.ai GLM-5.3 | 中国 | 44.8 | 42.3% | 1479 |
| 8 | Moonshot AI Kimi K3 | 中国 | 43.6 | 46.9% | 1488 |
| 9 | DeepSeek DeepSeek V4.1 Flash | 中国 | 39.5 | 41.0% DeepSeek V4 Pro | 1474 |
| 10 | Mistral Mistral Large 4 | 欧州 | 38.4 | 35.0% | 1427 Mistral Medium 3.5 |
| 11 | MiniMax MiniMax-M3 | 中国 | 29.2 | 39.0% | 1440 |
| 12 | Tencent Hy3 | 中国 | 25.3 | ― | 1456 |
| ― | Baidu ERNIE 5.1 | 中国 | ― | ― | 1468 |
| ― | ByteDance Seed 2.0 Pro | 中国 | ― | ― | 1457 |
順位は総合点の順です。太字は、それぞれの列のいちばん上。 数字の下の小さい文字は、その列だけ別のモデルの数字を使っているときの名前です。
⚠️ 見るときの注意
- とわラボ調べ:各サイトが公開している数字を、とわラボが2026年10月8日に集めて、1社1本に選んで並べたものです。サイトの公式のランキングそのものではありません
- グラフどうしは比べない:3つの物差しは目盛りがまったく違います
- 設定で変わる:同じモデルでも、考える強さの設定で数点変わります
- まだ使えないモデルもある:Gemini 4 Argon は今は一部の相手だけ、Mistral Large 4 は試験提供(プレビュー)です
- 選び方:各社の1本は、値段ではなく点数でいちばん上のモデルです。たとえば Anthropic は、値段が上の Fable 5.1 より Opus 5.5 のほうが、どの物差しでも上でした
- 日本のモデル:PLaMo や tsuzumi などは、どのランキングにも載っていなかったので入っていません
- すぐ変わる:新しいモデルが出ると、順位はすぐに入れ替わります
まとめると: 2026年10月時点では、Anthropic・OpenAI・Google のアメリカ3社が上位で、そのすぐ下に中国の会社が並んでいます。人の投票では中国の Kimi K3 が OpenAI より上になるなど、物差しによって順位は少しずつ変わります。
💬 今日のひとこと
並べてみて思ったのは、上位の差が思ったより小さいことでした。 総合点の1位と2位で5点、人の投票では誤差の幅が重なっている会社がたくさんあります。
ふだん使うぶんには、どれを選んでも大きな差はない、と言ってもいいくらいです。 それより、使いやすいアプリか、無料でどこまで使えるか、のほうが大事かもしれません。
日本のモデルが1つも載っていなかったのは、ちょっとさみしいところ。 載ったら、また並べてみます。
AIを仕事に入れてみたい方へ。 とわラボでは、AIの使い方のご相談や、AIを使ったWEBアプリづくりを承っています。お問い合わせはこちら